Cómo escribir Broken Bar
Para escribir Broken Bar (¦), pulse Alt + 0166 en Windows, manteniendo Alt mientras teclea las cifras en el teclado numérico, o escriba ¦ en HTML. En cualquier sistema puede copiarlo de esta página o introducir directamente su punto de código U+00A6: Ctrl+Mayús+U y luego 00a6 en Linux, o 00a6 y luego Alt+X en Microsoft Word.
Broken Bar (nombre Unicode, en inglés)
- Cópielo
- Unicode
- U+00A6
- Windows
- Alt + 0166
| Dónde | Atajo | Cómo |
|---|---|---|
| Windows | Alt + 0166 | Mantenga Alt y teclee el número en el teclado numérico. |
| Mac | N/A | Pulse las teclas a la vez. |
| HTML | ¦ | Pegue esto en el código fuente HTML. |
| Unicode | U+00A6 | BROKEN BAR |
Otros símbolos
¦ vive en el bloque Latin-1 Supplement (U+0080-U+00FF), las letras acentuadas y los signos corrientes que necesitaban las lenguas de Europa Occidental. Dentro de Unicode está clasificado como So, un símbolo.
Lo que Unicode dice de Broken Bar
El estándar reconoce ¦ también con otros nombres: broken vertical bar (1.0), parted rule (in typography). Son un alias formal y no un apodo, y por eso aparecen en la documentación de otra gente para ese mismo punto de código.
La tabla de códigos remite de ¦ a Línea vertical. Son los caracteres que el estándar cree que quizá quería usted en su lugar, lo que los convierte en los que conviene mirar cuando Broken Bar parece casi lo correcto y no del todo.
Cómo se comporta Broken Bar en los programas
¦ ocupa una columna en un terminal. No lleva dirección propia, así que en una línea que mezcla español con árabe o hebreo toma la dirección del texto que lo rodea en vez de imponer una.
Todas las formas de escribir Broken Bar
| Forma | Valor |
|---|---|
| Punto de código | U+00A6 |
| Decimal | 166 |
| Bytes UTF-8 | C2 A6 |
| Bytes UTF-16 | 00 A6 |
| Entidad HTML | ¦ |
| HTML numérico | ¦ o ¦ |
| CSS | \00A6 |
| JavaScript | \u00A6 |
| Python | \u00A6 |
| Codificado para URL | %C2%A6 |
| SVG | 00A6.svg · (SIL Open Font License) |
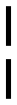
Si ¦ le llega como ¦
Ese es este mismo carácter, intacto: sus dos bytes UTF-8 C2 A6 se están leyendo de uno en uno como Windows-1252. Es en el rango Latin-1 donde más ocurre, porque es el rango que todo sistema heredado creía tener ya resuelto. No se ha perdido nada, y volver a teclear no servirá: el arreglo está en el extremo que lee, al que hay que decirle que el texto es UTF-8. Un rectángulo vacío es la queja contraria y significa que la codificación es correcta y que la fuente no tiene ningún glifo para U+00A6.